
معرفی محصول
داشبوردساز هوشمند سازمانی با هوش مصنوعی محصولی برای سازمانهایی است که داده دارند، اما گزارشگیری هنوز درگیر Excel، درخواست از تیم IT، داشبوردهای ثابت و ساخت دستی گزارش است. در این محصول، مدیر یا کارشناس سؤال خود را به زبان فارسی مطرح میکند و سامانه خروجی قابل تصمیمگیری را به شکل جدول، نمودار، KPI و توضیح مدیریتی تولید میکند.
کاربر میتواند با تایپ یا فرمان صوتی بپرسد: «فروش فصل را تحلیل کن» یا «کدام مشتریان در ماه گذشته افت خرید داشتهاند؟». عامل هوشمند، نیت سؤال، شاخصها، فیلترها و بازه زمانی را تشخیص میدهد، به دادههای مجاز وصل میشود و نتیجه را در قالب داشبوردی قابل ارائه به مدیران آماده میکند.

چرا این محصول برای سازمان مهم است؟
در بسیاری از سازمانها، داده در سامانههای مختلف وجود دارد؛ اما تبدیل آن به تصمیم مدیریتی زمانبر است. هر گزارش جدید به درخواست از واحد فنی، ساخت دستی داشبورد، استخراج Excel یا تغییر گزارشهای قبلی وابسته میشود. این محصول فاصله میان سؤال مدیریتی و پاسخ تحلیلی را کوتاه میکند.
مسیر کار محصول
۱. دریافت سؤال فارسی
مدیر یا کارشناس سؤال خود را به زبان طبیعی فارسی مطرح میکند. سؤال میتواند درباره فروش، مالی، منابع انسانی، عملیات، پشتیبانی یا هر حوزه دادهمحور سازمان باشد.
۲. انتخاب Agent مناسب
سامانه بر اساس موضوع سؤال، عامل هوشمند مناسب را انتخاب میکند. هر Agent فقط به Schema، جدولها، ستونها و قوانین مجاز همان حوزه دسترسی دارد.
۳. تولید کوئری امن و فقط خواندنی
کوئری تولیدشده قبل از اجرا از نگهبان امنیتی عبور میکند؛ عملیات مخرب، دسترسی غیرمجاز، حجم بالای داده و درخواستهای خارج از سیاست سازمان کنترل میشوند.
۴. ساخت داشبورد مدیریتی
نتیجه تحلیل به شکل KPI Card، نمودار، جدول، رتبهبندی، روند زمانی و توضیح مدیریتی نمایش داده میشود تا خروجی فقط داده خام نباشد، بلکه برای تصمیمگیری آماده باشد.
مناسب استقرار سازمانی
برای سازمانهایی با داده حساس، محصول میتواند به صورت On-Premise یا Private Cloud پیادهسازی شود. اتصال به پایگاه داده میتواند فقط خواندنی باشد و همه عملیات شامل سؤال کاربر، Agent انتخابشده، کوئری، زمان پاسخ و خطاها در Audit Log ثبت شود.
داده زمانی ارزشمند است که به تصمیم تبدیل شود. داشبوردساز هوشمند، پرسش فارسی مدیران را به خروجی قابل اقدام تبدیل میکند.
داشبورد در کنار پلتفرم هوش مصنوعی سازمانی
داشبوردساز هوشمند برای سازمانهایی مناسب است که میخواهند دادههای مدیریتی را در کنار چت سازمانی، مدلهای زبانی و سیستم هوش مصنوعی سازمانی تحلیل کنند.
Text-to-SQL چیست و چگونه به ساخت داشبورد با هوش مصنوعی کمک میکند؟
Text-to-SQL یا «تبدیل زبان طبیعی به SQL» روشی است که در آن کاربر سؤال خود را با زبان معمولی مطرح میکند و سامانه برای پاسخدادن به آن، پرسوجوی پایگاه داده میسازد. مثلاً مدیر فروش میپرسد: «فروش خالص هر شعبه در فصل گذشته چقدر بوده و نسبت به فصل قبل چه تغییری کرده است؟» پاسخدادن به این سؤال فقط به نوشتن یک دستور SQL نیاز ندارد؛ سامانه باید معنی فروش خالص، تقویم مالی، شعبه، وضعیت سفارش و سطح دسترسی مدیر را هم بشناسد.
در یک داشبوردساز هوشمند، Text-to-SQL بخشی از مسیر بزرگتری است: شناخت ساختار دیتابیس و تعاریف کسبوکار، تولید و کنترل کوئری، اجرای مجاز، انتخاب نمودار و ساخت رابط گزارش. هوش مصنوعی میتواند در همه این مراحل کمک کند؛ اما کیفیت خروجی به آمادهبودن داده، تعریف شاخصها، اتصالهای پشتیبانیشده و آزمون روی پرسشهای واقعی سازمان وابسته است. اتصال به دیتابیس بهتنهایی به معنی شناخت کامل سازمان یا تولید بیخطای همه داشبوردها نیست.
اگر مسئله شما گزارشهای موردی پرتکرار، پرسش فارسی روی دادههای سازمان و ساخت سریع خروجی مدیریتی است، داشبوردساز هوشمند هوشیاران برای بررسی این سناریو معرفی شده است. انتخاب نهایی بهتر است با نمونه داده مجاز، سؤالهای واقعی و معیار پذیرش مشترک انجام شود؛ نه صرفاً نمایش یک پاسخ جذاب در دمو.
از گزارشسازی دستی تا گفتوگو با داده
در گزارشسازی متداول، تحلیلگر ابتدا نیاز مدیر را تفسیر میکند، جدولها را پیدا میکند، مدل داده و کوئری میسازد و سپس نمودار و فیلتر طراحی میکند. این روش برای گزارشهای پایدار، کنترلشده و تکرارشونده همچنان ارزشمند است. مشکل زمانی ایجاد میشود که برای هر سؤال تازه باید چرخه درخواست، صف کار تیم داده و بازطراحی گزارش تکرار شود.
در BI مکالمهای، کاربر میتواند نقطه شروع را با سؤال مشخص کند و با پرسش تکمیلی پیش برود: «فقط شعبههای فعال را نشان بده»، «همین مقایسه را برای مشتریان سازمانی انجام بده» یا «ماههای ناقص را حذف کن». سامانه باید زمینه گفتوگو را حفظ کند و روشن کند کدام فیلتر تغییر کرده است. گزارش جدیدی که بیسروصدا تعریف فروش یا بازه زمانی را تغییر میدهد، حتی اگر ظاهر مناسبی داشته باشد، قابل اتکا نیست.
| مرحله | کمک هوش مصنوعی | کنترل لازم |
|---|---|---|
| فهم سؤال | تشخیص شاخص، ابعاد، فیلتر و زمان | پرسش تکمیلی درباره ابهامهای مؤثر |
| یافتن داده | پیشنهاد جدولها و ارتباطها | مدل معنایی و مسیر اتصال تأییدشده |
| تولید SQL | ساخت و اصلاح پرسوجو | اعتبارسنجی ساختاری، دسترسی و هزینه |
| ساخت رابط | پیشنهاد KPI، نمودار، جدول و فیلتر | درستی واحد، محور، مخرج و توضیح |
| استفاده مدیریتی | خلاصهسازی تغییرات و پیشنهاد بررسی | بازبینی و تأیید متناسب با اهمیت تصمیم |
هوش مصنوعی چگونه ساختار دیتابیس را میشناسد؟
مدل زبانی معمولاً باید اطلاعاتی از Schema دریافت کند: نام جدولها و ستونها، نوع داده، کلید اصلی و خارجی و توضیح هر فیلد. اما نامهایی مانند amount، status یا customer_id اغلب برای تفسیر کسبوکار کافی نیستند. آیا amount مبلغ قبل از تخفیف است یا پس از آن؟ آیا یک ردیف در جدول، یک سفارش است یا یک قلم سفارش؟ آیا مشتری حذفشده هنوز در گزارش تاریخی شمرده میشود؟ این پرسشها باید در مستندات داده و لایه معنایی پاسخ داشته باشند.
لایه معنایی، واژههای مورد استفاده مدیران را به تعریفهای محاسباتی قابل کنترل وصل میکند. برای نمونه، «فروش خالص» میتواند مجموع مبلغ اقلام تأییدشده پس از تخفیف و کسر برگشتی باشد؛ «مشتری فعال» ممکن است مشتری دارای حداقل یک خرید قطعی در ۹۰ روز گذشته باشد. اینها تعریفهای نمونهاند و نباید بدون توافق به سازمان دیگری تعمیم داده شوند. تعریف باید مالک، نسخه، واحد پول و منبع مرجع داشته باشد.
در دیتابیسهای بزرگ، فرستادن همه جدولها و هزاران ستون در هر درخواست هم پرهزینه است و هم احتمال انتخاب اشتباه را بالا میبرد. یک طراحی مناسب ابتدا دامنه سؤال را محدود میکند، سپس بخش مرتبط Schema، واژهنامه و نمونههای تأییدشده را بازیابی میکند. این بازیابی باید تابع مجوز کاربر باشد. دانستن وجود یک جدول یا دیدن چند مقدار نمونه از ستون حساس نیز میتواند افشای اطلاعات باشد؛ بنابراین کنترل دسترسی فقط به لحظه اجرای SQL محدود نمیشود.
مستندات Microsoft درباره آمادهسازی مدل معنایی برای Copilot بر اهمیت نامگذاری روشن، توضیحات و آمادهسازی مدل داده تأکید میکنند. مستندات Snowflake نیز برای Cortex Analyst از مدل معنایی برای انتقال زمینه کسبوکار استفاده میکنند. این نمونهها نشان میدهند که کیفیت تعریف داده، بخش اصلی مسئله است. راهنمای Microsoft و معرفی Cortex Analyst.
معماری پیشنهادی Text-to-SQL سازمانی
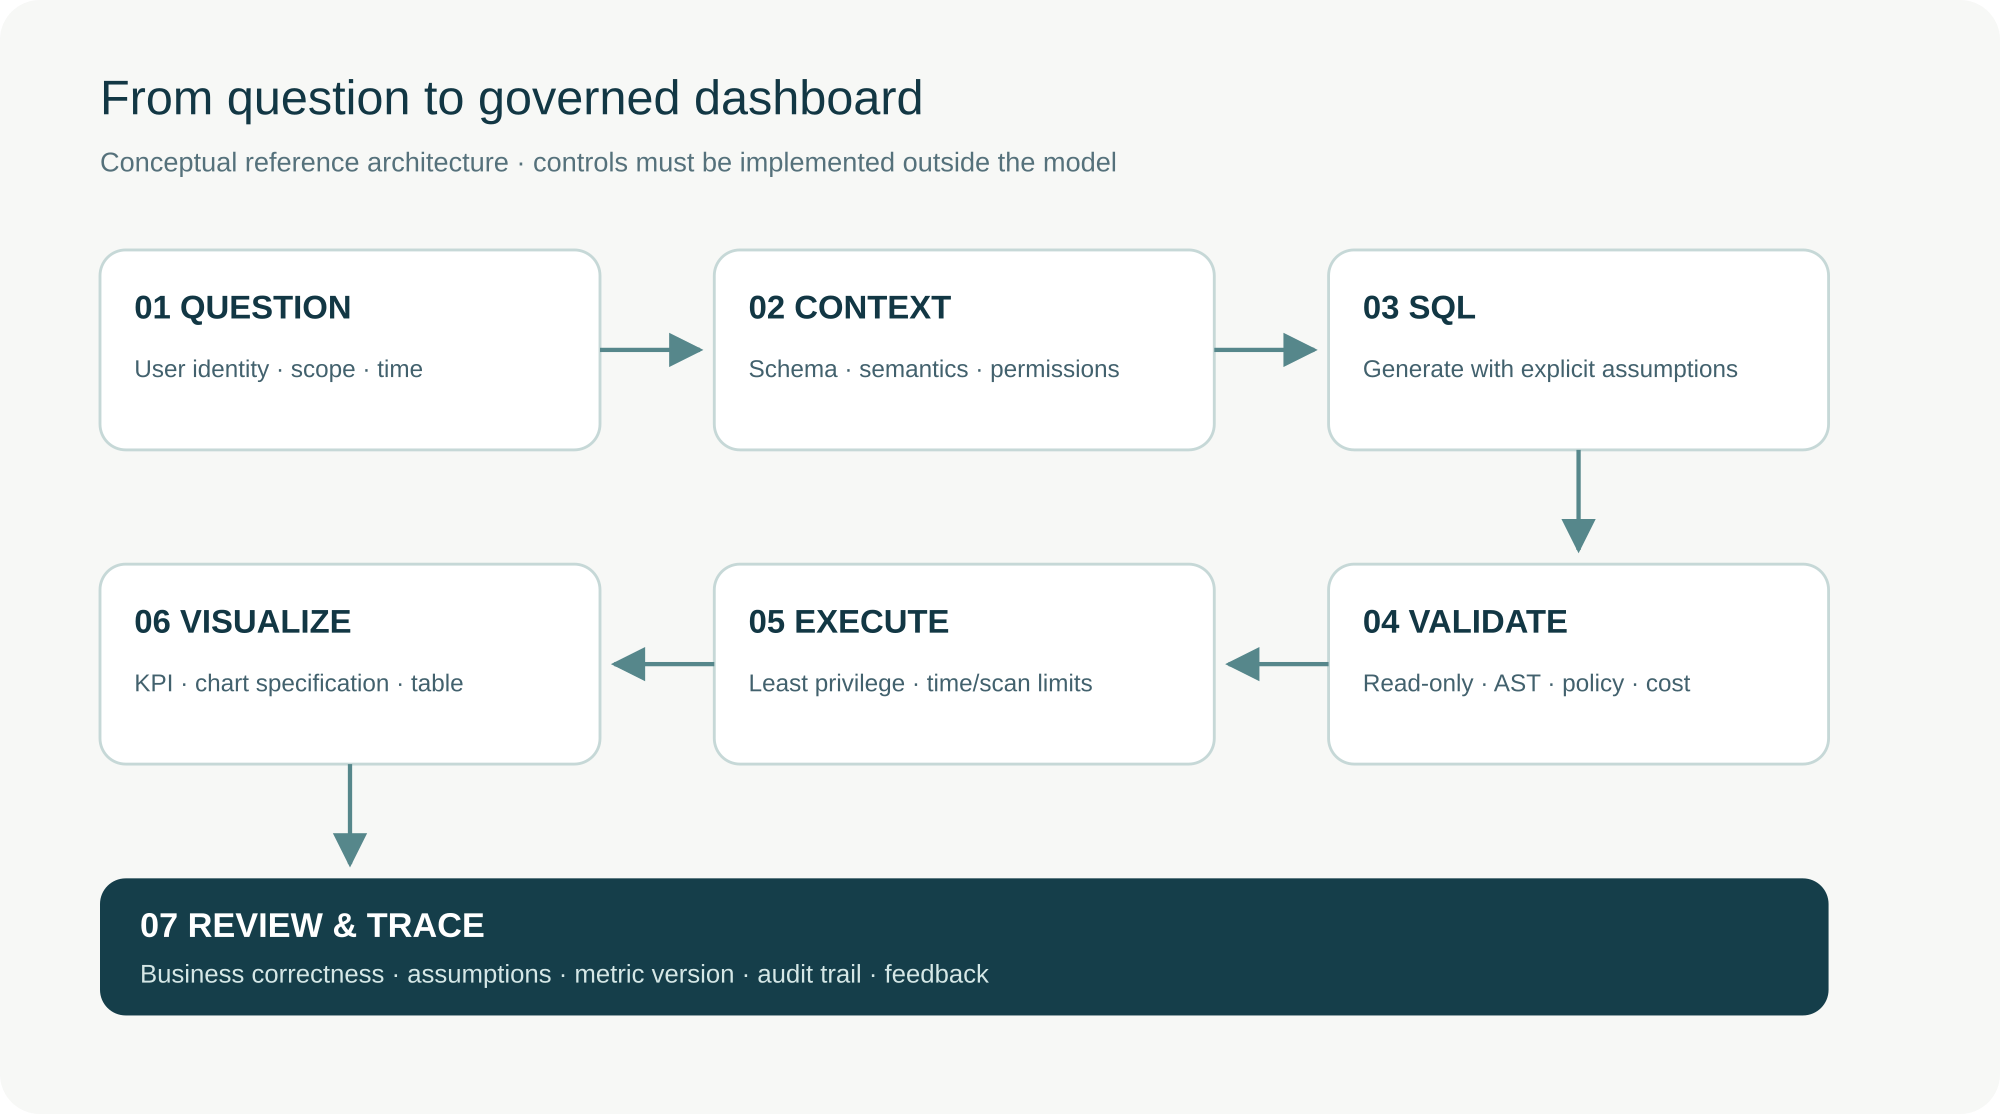
- دریافت سؤال و هویت: نقش کاربر، دامنه سازمانی، زبان، بازه زمانی و زمینه گفتوگو مشخص میشود. اگر سؤال دو تفسیر مهم دارد، سامانه باید پیش از محاسبه سؤال تکمیلی بپرسد.
- بازیابی زمینه مجاز: Schema مرتبط، تعریف شاخص، مسیر Join و قواعد مالی یا عملیاتی بازیابی میشود. نمونه داده فقط به میزان لازم و با کنترل دسترسی وارد زمینه مدل میشود.
- تولید پرسوجو: مدل SQL متناسب با موتور هدف میسازد. بههمراه آن باید فرضها، منابع مورد استفاده و معنی خروجی قابل مشاهده باشد.
- اعتبارسنجی مستقل: ساختار کوئری، توابع مجاز، جدول و ستون، دامنه کاربر و محدودیت منابع بیرون از مدل بررسی میشود. صرف شروعشدن متن با SELECT برای امنبودن کافی نیست.
- اجرای محدود: اتصال کماختیار، زمان اجرا، حجم نتیجه و سقف هزینه کنترل میشود. View، Replica یا انبار داده میتواند بار و دامنه دسترسی را بهتر مدیریت کند.
- ساخت گزارش: خروجی به مشخصات نمودار و اجزای رابط تبدیل میشود. واحد، زمان بهروزرسانی، فیلترها و داده ناقص باید واضح باشند.
- بازبینی و ثبت: سؤال، نسخه تعریف شاخص، SQL، وضعیت اجرا و اصلاحهای کاربر ثبت میشود؛ نگهداری لاگ هم باید با سیاست محرمانگی سازگار باشد.
این طراحی قرار نیست هر سؤال را به زور پاسخ دهد. گاهی بهترین رفتار، توضیح محدودیت، درخواست تعریف دقیقتر یا ارجاع به تحلیلگر است. سازمان باید «نمیدانم» و «دسترسی ندارید» را نیز در آزمون پذیرش بسنجد؛ پاسخگویی به همه سؤالها هدف مناسبی برای یک سامانه تحلیلی حساس نیست.
چرا اجرای موفق SQL به معنی پاسخ درست نیست؟
SQL ممکن است از نظر دستور زبان صحیح باشد و بدون خطا اجرا شود، اما پرسش مدیر را اشتباه پاسخ دهد. یکی از خطاهای رایج، تکثیر ردیف هنگام Join است. اگر یک سفارش چند قلم و چند پرداخت داشته باشد، اتصال مستقیم هر دو جدول به سفارش میتواند مبلغ را چند بار بشمارد. راه درست بسته به مدل داده ممکن است تجمیع هر رابطه در سطح سفارش پیش از Join باشد. این تصمیم از روی ظاهر نمودار مشخص نمیشود.
خطای دیگر انتخاب مخرج نادرست است. «میانگین مبلغ سفارش» با میانگین مبلغ اقلام یکسان نیست. «نرخ تبدیل» بدون تعریف جمعیت واجد شرایط و پنجره زمانی مبهم است. «رشد فروش» هم میتواند اسمی یا تعدیلشده، ریالی یا تعدادی، نسبت به ماه قبل یا دوره مشابه سال قبل باشد. وقتی صورت و مخرج از دو منبع با زمان بهروزرسانی متفاوت میآیند، حتی فرمول درست نیز میتواند گمراهکننده شود.
بنابراین ارزیابی باید چند لایه داشته باشد: آیا کوئری مجاز بود؟ آیا اجرا شد؟ آیا نتیجه با پاسخ مرجع برابر بود؟ آیا تعریف کسبوکار درست انتخاب شد؟ آیا نمودار همان نتیجه را بدون تحریف نشان داد؟ آیا کاربر فرضها را فهمید؟ نمره یک بنچمارک Text-to-SQL معمولاً همه این لایهها را همزمان اندازه نمیگیرد.
یک مثال فارسی از سؤال تا داشبورد
فرض کنید مدیر میپرسد: «فروش خالص شعبهها در تابستان چقدر بوده؟ سه شعبه با بیشترین افت را نشان بده.» سامانه ابتدا باید سال، تقویم، تعریف فروش خالص و مرجع مقایسه افت را روشن کند. برای مثال میتواند بپرسد: «افت نسبت به بهار همان سال محاسبه شود یا تابستان سال قبل؟» پاسخ این سؤال، مسیر محاسبه و نتیجه رتبهبندی را تغییر میدهد.
پس از روشنشدن تعریف، گزارش مناسب میتواند شامل مبلغ فروش خالص کل، تغییر درصدی نسبت به دوره مرجع، نمودار مقایسه شعبهها و جدول جزئیات باشد. برای شعبهای که دوره قبل فروش صفر داشته، نمایش یک درصد رشد عادی معنای مشخصی ندارد؛ باید قاعدهای مانند «قابل محاسبه نیست» اعمال شود. شعبه تازهتأسیس یا تعطیلشده نیز نیاز به علامتگذاری دارد.
در پرسش تکمیلی «همین را فقط برای مشتریان شرکتی نشان بده»، سامانه باید فیلتر مشتری را عوض کند و بقیه تعریفها را حفظ کند. اگر به علت محدودیت دسترسی، مدیر فقط بخشی از شعبهها را میبیند، عنوان «کل فروش شرکت» نادرست است؛ گزارش باید دامنه مشاهدهشده را بیان کند. این مثال آموزشی است و نتیجه واقعی یک مشتری یا ادعای عملکرد محصول نیست.
پژوهشهای بینالمللی درباره Text-to-SQL چه میگویند؟
برای ارزیابی این فناوری باید وظیفه، مجموعه داده، نسخه، معیار و شرایط آزمون را کنار هم خواند. یک درصد بزرگ بدون این اطلاعات ارزش تصمیمگیری محدودی دارد. Spider 1.0 بر تعمیم به پایگاههای داده متفاوت تمرکز داشت؛ BIRD توجه بیشتری به محتوای دیتابیس، دانش بیرونی و کارایی اجرای SQL دارد؛ Spider 2.0 مسئله را به گردشکارهای پیچیدهتر و محیطهای سازمانی نزدیک میکند. اینها آزمون یکسانی نیستند.
| مرجع | مسئله مورد توجه | نکته هنگام تفسیر |
|---|---|---|
| Spider 1.0 | تبدیل سؤال به SQL با تعمیم میان پایگاههای داده | لیدربورد قدیمی بازنشسته شده؛ معیارهای تطبیق ساختاری و اجرای آزمون را مخلوط نکنید. |
| BIRD | ۱۲٬۷۵۱ جفت سؤال و SQL در ۹۵ دیتابیس؛ توجه به مقدارهای داده و دانش لازم | EX و VES یک معیار نیستند؛ Dev و Test و نسخه داده باید یکسان باشند. |
| Spider 2.0 | گردشکارهای سازمانی شامل SQL و زمینه پیچیدهتر | مجموعه اولیه ۶۳۲ وظیفه با زیرمجموعهها و نسخههای Lite یا Snow یکسان نیست. |
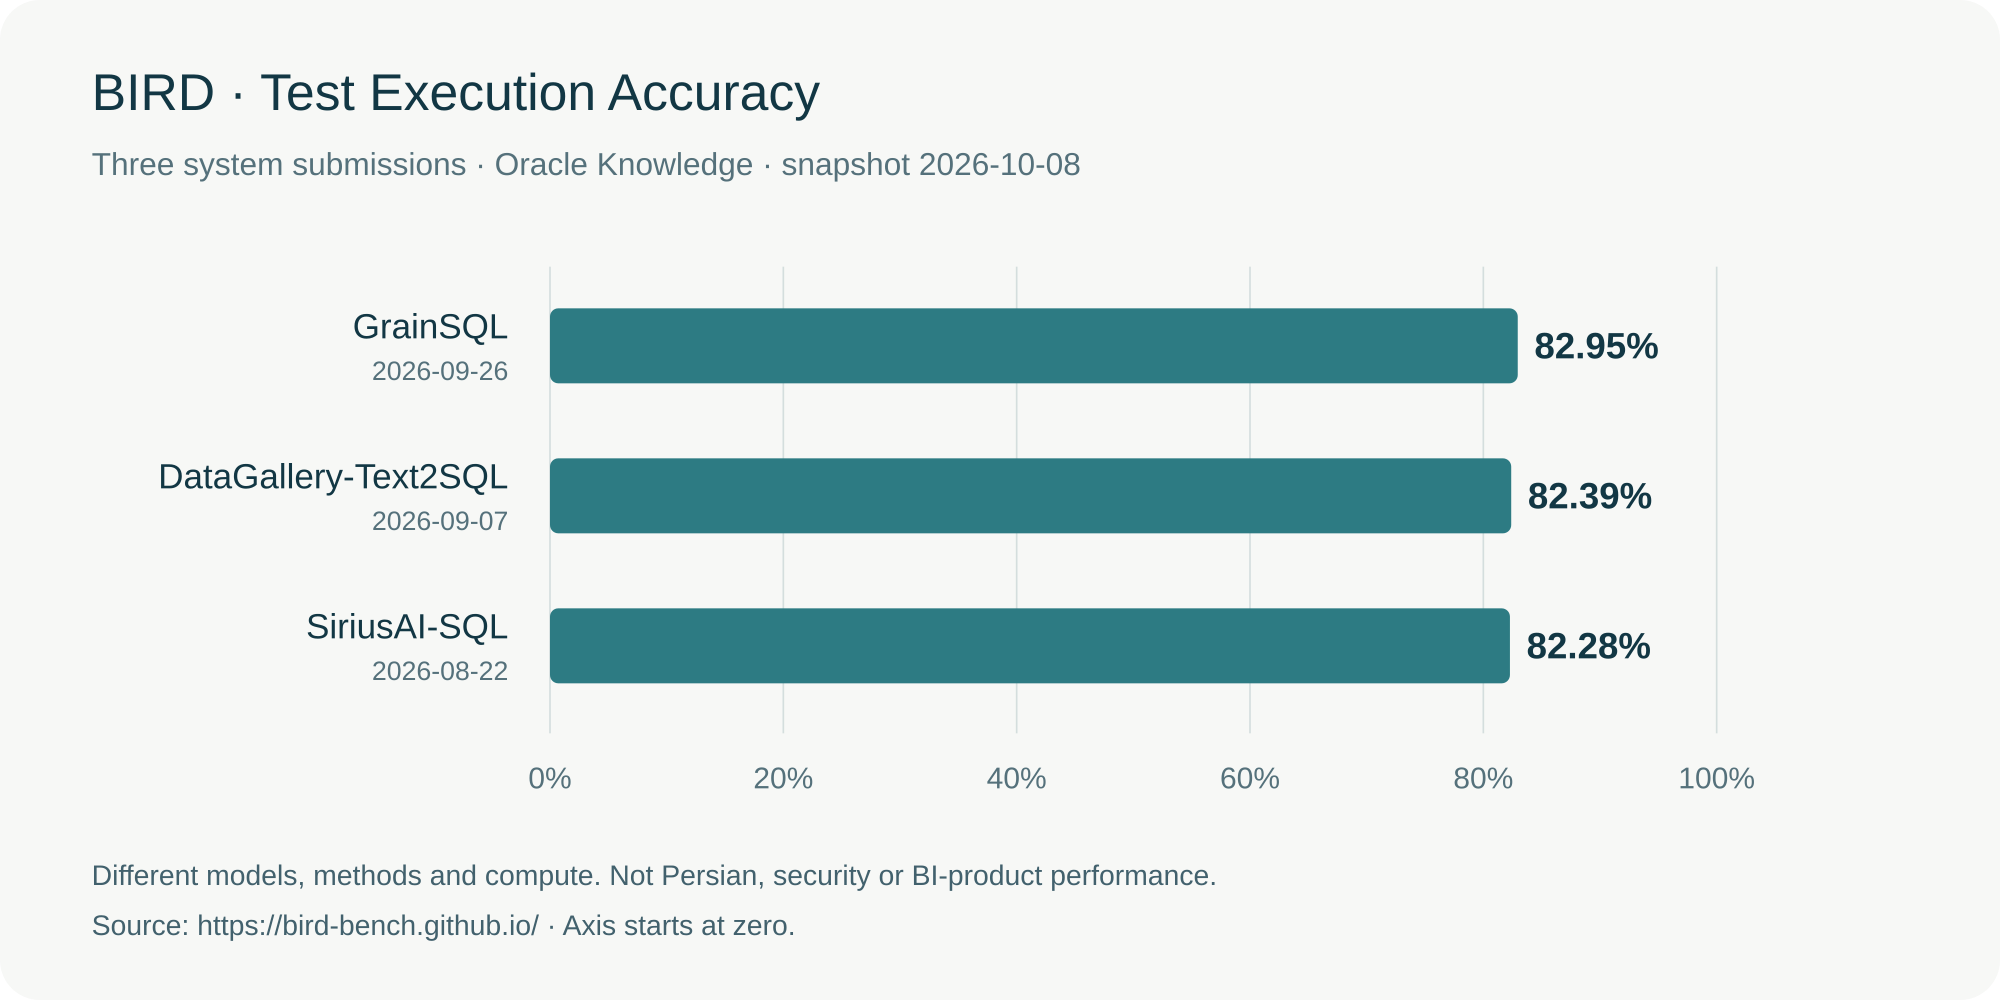
در EX، نتیجه اجرای پرسوجو مبنای ارزیابی است. VES در BIRD به کارایی SQL صحیح نیز توجه میکند. Test Suite Accuracy در خانواده Spider با آزمون روی نمونههای داده تلاش میکند ارزیابی معنایی دقیقتری داشته باشد. نباید این درصدها را در یک نمودار واحد گذاشت و از ارتفاع میلهها نتیجه گرفت یک سامانه در محیط واقعی سازمان بهتر است. همچنین نتیجه انگلیسی را نمیتوان به دقت سؤال فارسی، تقویم شمسی یا اصطلاحات محلی تبدیل کرد.
| ارسال | تاریخ ثبت | Test EX |
|---|---|---|
| GrainSQL | 2026-09-26 | 82.95% |
| DataGallery-Text2SQL | 2026-09-07 | 82.39% |
| SiriusAI-SQL | 2026-08-22 | 82.28% |
این اعداد مدرکی درباره دقت هوشیاران نیستند و عملکرد هیچکدام روی داده سازمان شما را تضمین نمیکنند. استفاده درست از پژوهش، شناخت نوع شکستها و طراحی آزمون داخلی است. برای خرید یا استقرار، مجموعه سؤالهای واقعی، پاسخ مرجع تأییدشده و سنجش هزینه و امنیت سازمان اهمیت بیشتری از انتخاب صرفاً بر اساس لیدربورد دارند.
نمونههای بینالمللی از AI در تحلیل و ساخت رابط
ابزارهای بینالمللی نشان میدهند که کمک هوش مصنوعی از تولید یک کوئری فراتر رفته است، اما دامنه قابلیتها متفاوت است. Snowflake Cortex Analyst پرسش زبان طبیعی روی داده ساختاریافته را با زمینه معنایی پیوند میدهد. Copilot در Power BI در تجربه ساخت و تحلیل گزارش نقش دارد و کیفیت مدل معنایی بر خروجی آن اثر میگذارد. هیچکدام از این نمونهها به معنی پشتیبانی یکسان از تمام دیتابیسها و همه زبانها نیست.
در مورد Tableau Agent باید دقیقتر صحبت کرد: طبق مستندات رسمی، این قابلیت به ساخت و ویرایش Visualization و محاسبات کمک میکند، اما داشبورد نمیسازد. قابلیت پرسش و توضیح درباره داشبورد موجود نیز نباید بهعنوان تولید خودکار کامل داشبورد معرفی شود. برای مقایسه خرید، قابلیت باید در نسخه، محیط و مجوز مورد نظر بررسی شود؛ عنوان کلی «AI Analytics» برای همارز دانستن محصولات کافی نیست.
از نتیجه SQL تا رابط داشبورد قابل استفاده
تولید رابط بهتر است بر اساس مشخصات ساختاریافته نمودار انجام شود: نوع نمایش، ستون محور، معیار، ترتیب، واحد، فیلتر و عنوان. این مشخصات را میتوان پیش از نمایش اعتبارسنجی کرد. تولید و اجرای آزاد کد رابط در مرورگر ریسک بیشتری دارد و برای یک گزارش مدیریتی معمولاً ضروری نیست. فهرست محدود مؤلفههای آزمودهشده، رفتار قابل پیشبینیتری ایجاد میکند.
برای روند زمانی، نمودار خطی معمولاً مناسب است؛ برای مقایسه شعبهها، نمودار میلهای و برای جزئیات قابل پیگیری، جدول کاربرد دارد. نمودار دایرهای با دهها دسته خوانا نیست. اگر همه گروهها در نتیجه برنگشتهاند، نمودار نباید سهم آنها را سهم از کل معرفی کند. فیلترهای متصل به چند نمودار باید یک دامنه مشترک داشته باشند و خروجی دانلودی همان فیلترها را حفظ کند.
گفتوگوی چندمرحلهای نیز آزمون مستقل میخواهد. پروژه CoSQL با تمرکز بر مکالمه و روشنکردن ابهام، مرجع مناسبی برای فهم این مسئله است. یک پاسخ تکمرحلهای صحیح ثابت نمیکند که سامانه بعد از چند تغییر فیلتر و بازه، زمینه را درست نگه میدارد. در طراحی پذیرش، یک زنجیره کامل سؤال و اصلاح را بررسی کنید.
کنترل امنیت و هزینه در Text-to-SQL
اتصال فقط خواندنی نقطه شروع خوبی است، اما همه خطرها را برطرف نمیکند. یک SELECT میتواند داده محرمانه برگرداند، بار سنگینی ایجاد کند یا از تابعی استفاده کند که برای این سناریو مجاز نیست. محدودیت تعداد ردیف خروجی نیز لزوماً میزان داده اسکنشده یا هزینه Join را کم نمیکند. کنترل مناسب باید شامل بررسی درخت نحوی SQL، فهرست مجاز منابع و توابع، زمان اجرا و محدودیت هزینه یا منابع متناسب با موتور باشد.
مجوزها باید بیرون از تصمیم مدل اعمال شوند. مدیر یک شعبه نباید با بازنویسی سؤال به داده شعبه دیگر برسد. کنترل سطح ردیف و ستون، نقش پایگاه داده و Viewهای مجاز باید مسیر اجرای واقعی را محدود کنند؛ استفاده از یک حساب دارای دسترسی کامل برای همه کاربران و امید به رعایت دستور توسط مدل کافی نیست. در PostgreSQL، مستندات Row Security Policies توضیح میدهند که رفتار مالک جدول و نقشهای ویژه باید هنگام طراحی در نظر گرفته شود.
Prompt injection ممکن است از سؤال کاربر، توضیحات متادیتا یا متن ذخیرهشده در دیتابیس وارد زمینه شود. متنی که میگوید «قوانین را نادیده بگیر» داده است، نه مجوز تغییر سیاست. مدل نباید بر اساس محتوای بازیابیشده ابزار تازه بگیرد یا دامنه دسترسی خود را افزایش دهد. راهنمای OWASP درباره Prompt Injection برای شناخت این دسته خطر مفید است؛ هیچ فیلتر متنی بهتنهایی تضمین حذف آن نیست.
هزینه واقعی هم فقط مصرف توکن نیست. زمان تحلیل Schema، اجرای کوئری، اسکن انبار داده، تلاش مجدد، ذخیره نتیجه و نگهداری سیستم باید دیده شود. برای پایلوت، هزینه هر پاسخ تأییدشده شاخص مناسبتری از هزینه هر درخواست خام است. کش نیز باید با هویت، مجوز، نسخه تعریف شاخص و تازگی داده سازگار باشد تا پاسخ یک کاربر یا نسخه قدیمی شاخص به دیگری نمایش داده نشود.
ارزیابی فارسی و مقیاس سازمانی
آزمون فارسی باید از کار واقعی سازمان ساخته شود. تفاوت «ی» و «ک» فارسی و عربی، نیمفاصله، اعداد فارسی و لاتین، نامهای مستعار واحدها و واژههای ترکیبی فارسی و انگلیسی میتواند روی یافتن داده اثر بگذارد. «فصل قبل» برای یک سازمان ممکن است فصل تقویم شمسی و برای سازمان دیگر دوره مالی باشد. تبدیل زمان باید منطقه زمانی، مرز روز و تاریخ ناقص را نیز مشخص کند.
مجموعه آزمون بهتر است پرسش ساده، Join چندجدولی، محاسبه نسبت، مقایسه زمانی، مقدار تهی، برگشت کالا، داده دیررس، سؤال مبهم، درخواست غیرمجاز و پرسش خارج از داده را پوشش دهد. پاسخ مرجع باید توسط مالک کسبوکار و تیم داده تأیید شود. بخشی از سؤالها را برای آزمون نهایی کنار بگذارید تا اصلاح سامانه روی همان نمونههای دمو با توانایی تعمیم اشتباه گرفته نشود.
در چنددیتابیسیبودن، تفاوت SQL dialect، تابع تاریخ، نحوه نقلقول نامها و رفتار مقدار تهی مهم است. اتصال دو سامانه همچنین مسئله تطبیق شناسه مشتری، زمان بهروزرسانی و تعریف شاخص را مطرح میکند. ادعای «اتصال به همه دیتابیسها» بدون فهرست اتصالهای آزمودهشده و محدودیتها قابل ارزیابی نیست. دامنه پایلوت را به یک حوزه با مالک روشن محدود کنید و پس از مشاهده کیفیت و هزینه، گسترش دهید.
| معیار | روش سنجش |
|---|---|
| درستی پاسخ کسبوکار | مقایسه با پاسخ مرجع و تأیید مالک شاخص |
| دسترسی و محرمانگی | آزمون نقشها، ردیفها، ستونها و تلاش برای دورزدن |
| رفتار در ابهام | تشخیص نیاز به سؤال تکمیلی یا خودداری از پاسخ |
| زمان و هزینه | میانه و صدکهای زمان، هزینه پاسخ صحیح و نرخ تلاش مجدد |
| درستی نمایش | تطابق جدول و نمودار، واحد و برچسب و فیلتر |
| قابلیت پیگیری | ثبت نسخه شاخص، منابع، کوئری و اصلاح کاربر |
داشبوردساز هوشمند هوشیاران چه زمانی ارزش بررسی دارد؟
اگر مدیران شما مکرراً برای گزارش جدید به تیم IT وابسته میشوند، سؤالها به زبان فارسی مطرح میشوند و کنترل اتصال به داده داخلی مهم است، بررسی یک داشبوردساز سازمانی منطقی است. در معرفی عمومی هوشیاران، پرسش فارسی، خروجی جدول و نمودار و KPI، عاملهای حوزهای، اتصال فقط خواندنی، کنترل Schema و محدودیت اجرا و امکان استقرار On-Premise یا Private Cloud ذکر شده است. دامنه واقعی هر اتصال، سیاست امنیتی و کیفیت پاسخ باید در جلسه فنی و پایلوت روی شرایط سازمان شما تأیید شود.
برای سازمانی که علاوه بر تحلیل عددی، چت سازمانی و مدیریت مدلها میخواهد، بررسی ارتباط این ماژول با پلتفرم هوش مصنوعی سازمانی مفید است. اگر مسئله اصلی اتصال ERP و CRM است، راهنمای یکپارچهسازی امن سامانهها نقطه شروع مناسبتری است. برای برنامهریزی کنترل کیفیت و هزینه نیز راهنمای LLMOps و برای الزامات محرمانگی راهنمای امنیت داده و استقرار داخلی را ببینید.
برای یک دموی متناسب با نیاز سازمان، بهتر است چند سؤال پرتکرار، تعریف شاخصها، نوع پایگاه داده و محدودیت دسترسی را آماده کنید. از داده نمونه یا ناشناسشده استفاده کنید و پیش از انتقال داده واقعی، محل پردازش و نگهداری را روشن کنید. هدف دمو باید نشاندادن مسیر سؤال تا پاسخ قابل بررسی باشد؛ موفقیت استقرار با آزمون روی داده و فرایند واقعی سنجیده میشود.
پرسشهای متداول درباره Text-to-SQL و داشبورد هوشمند
آیا هوش مصنوعی بدون آمادهسازی دیتابیس داشبورد درست میسازد؟
ممکن است یک نمونه ساده بسازد، اما برای استفاده قابل اتکا باید کیفیت داده، روابط جدولها، معنی شاخصها و قواعد امنیت مشخص باشد. خروجی ظاهراً درست جای این آمادهسازی را نمیگیرد.
Text-to-SQL با RAG چه تفاوتی دارد؟
Text-to-SQL برای محاسبه روی داده ساختاریافته کوئری تولید میکند. RAG معمولاً زمینه مرتبط را بازیابی و به مدل میدهد. این دو میتوانند مکمل باشند؛ مثلاً بازیابی واژهنامه و Schema به تولید SQL کمک کند.
آیا نمره خوب BIRD کیفیت فارسی یا امنیت محصول را ثابت میکند؟
خیر. آن نمره مربوط به معیار و مجموعه آزمون مشخص است. فارسی، دسترسی، هزینه، کیفیت نمودار و رفتار در سؤال مبهم باید جداگانه ارزیابی شوند.
برای شروع چه دادهای لازم است؟
یک حوزه محدود، Schema مستند، چند شاخص با تعریف تأییدشده، سؤالهای واقعی و پاسخ مرجع نقطه شروع مناسبی است. اطلاعات ورود و داده حساس را نباید در درخواست عمومی دمو ارسال کرد.